問い合わせメールの振り分けや、部品の欠陥検査をAIに任せようとすると、判定のたびに「自信80%」のような数字がついてくる。この数字、どこまで信じて自動処理に回していいのだろうか。
2026年10月15日、Liquid AIが新しい判定AI「d1-ultra」を公開した(GIGAZINE)。文章を生成せず判定だけを返す「決定モデル」というジャンルを、本サイトはこれまでJev・Clef・OpenAIのDecisions APIの3回で扱ってきた。Liquid AI公式ブログによると、d1-ultraはこの系譜の中で性能の総合指標トップに立った。それだけでなく、「自信の数字がどれだけ正しいか」という、これまで扱ってこなかった物差しでも際立つ結果を出している。
性能面でもJevを上回る
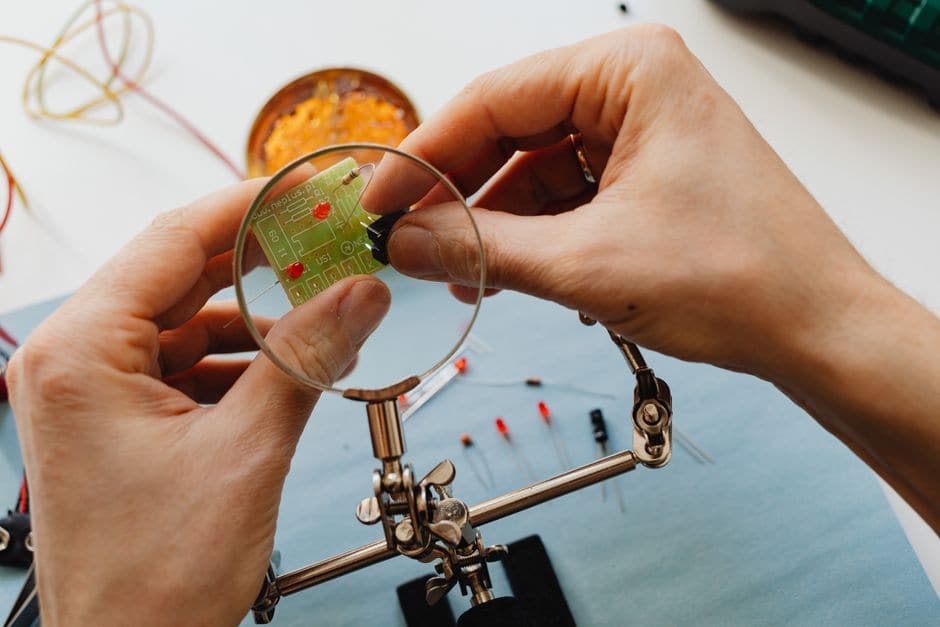
d1-ultraは、文章と画像の両方を入力に取り、選択肢の確率を直接返すモデルだ。公式ブログが例に挙げるのは、回路基板の写真を渡して「欠陥は何か」を「部品の欠落」「余分な部品」「傷」の3択で判定させる場面だ。単純な一問一答ではなく、実務でありがちな雑多な判定を想定して作られている。
性能の比較には、Artificial Analysisという独立した評価機関が運営する「Artificial Analysis Decision Index」が使われた。知識・ハルシネーション、推論、ツール呼び出し、分類という4つの評価を均等に(各25%)組み合わせた指標だ(Artificial Analysis)。
d1-ultraは65点で、先行するJev 1.14の57点を8ポイント引き離した(Liquid AI公式ブログ)。自社の前身モデルd1(50点)からも大きく伸びている。内訳を見ても差は一様だ。道具を選んで操作する判定(tools and agents)は、d1-ultraが82.8点、Jevが74.2点だった。44言語をまたいだ判定(languages)でも80.2点対74.0点で、個別の分野ごとに6〜9点ほどの差がついている(同ブログ)。この並びだけ見ると、「また新顔が性能トップに立った」といういつもの話に見える。だが、d1-ultraが前面に押し出しているのは、この総合点ではなかった。
「当たる」と「自信が正しい」は別の話
天気予報で「降水確率70%」と言われた日が10日あったとする。その10日のうち7日くらい実際に雨が降っていれば、その予報は「よく当たる」というより「よく較正されている」と言う。逆に7割の自信で言った予報が3日しか当たらなければ、降水確率という数字そのものが信用できなくなる。
判定AIの「自信80%」も、同じように測れる。実際にその判定が正しかった割合と、AIが自己申告した自信の数字を突き合わせ、ズレの大きさを見る。これを確信度の較正(キャリブレーション)と呼ぶ。公式ブログは、こう説明している。「正答率だけでは足りない。判定モデルが出す確率も、きちんと較正されている必要がある」。そのうえで「多くの判定モデルは、自分の答えに対して過信しがちだと気づいた。だからこそd1-ultraは、より信頼できる確率を出すよう特別に学習させた」と述べている。
つまり、正答率が高いことと、自信の数字が正しいことは、別の軸で測れる話だ。
この違いは、冒頭の「自信80%未満は人に回す」という運用を組むときに効いてくる。仮に、ある判定の実際の正答率が60%なのに、較正の甘いモデルが「自信90%」と表示したとする。この場合、閾値を90%に置いても、本当は4割外れている判定がそのまま自動処理をすり抜けてしまう。自信の数字そのものが歪んでいると、閾値をどこに引いても意味が薄れる。
自信が一番狂っていたのは最大手
較正の正確さは「平均較正誤差(自信と正答率のズレの平均)」という数値で表される。値が小さいほど、自信の数字を信じてよいという意味になる。
d1-ultraの較正誤差は1.5で、先ほどの性能比較と同じ並びでJevやClefを上回った(Liquid AI公式ブログ)。ここまでは予想どおりだ。意外だったのは、最も過信気味(較正誤差7.2)だったのが、無名の新興モデルではなく、OpenAIのGPT-6 Luna(Decisions API)だったことだ。自分は「最大手なら、このあたりの手堅さも含めて作り込んでいるはず」と考えていたので、比較対象の中で最も自信過剰という結果には二度見した。較正という一点に絞った調整では、後発の専業企業(Liquid AI、TypeSafe AI)の方が上回っていたことになる。
この較正誤差の数値はLiquid AI自身が測定したもので、第三者による独立検証は今のところ見当たらない。総合指標の運営元であるArtificial Analysisとは別の集計である点には注意が要る。性能と較正の両方で好成績だったd1-ultraだが、実際に手元で試すにはどこから入ればいいのだろうか。
使うなら何を確認するか
d1-ultraの利用は、現時点でLiquid AIのAPI(console.liquid.ai)と、体験用の「d1 Playground」(d1.liquid.ai)に限られる。Vercel・OpenRouter経由の提供は「近日対応予定」とされ、まだ始まっていない(Liquid AI公式ブログ)。
価格は入力100万トークンあたり0.042ドルで、出力側の課金はない。これはJevとまったく同じ単価だ(TypeSafe AI公式ブログ)。先行するClefは0.24ドル(Cloudflare公式ブログ)、OpenAIのDecisions APIは0.10ドル(OpenAI公式ドキュメント)だ。d1-ultraは、この中で最も安いJevと同額になる。
| 価格(入力100万トークンあたり) | 利用方法 | |
|---|---|---|
| Jev | 0.042ドル | クローズドAPI |
| d1-ultra | 0.042ドル | クローズドAPI(Liquid API。Vercel・OpenRouterは近日予定) |
| Clef | 0.24ドル | Cloudflare Workers AIまたは自分のサーバー(オープンウェイト) |
| OpenAI Decisions API | 0.10ドル | クローズドAPI(GPT-6 Lunaのみ) |
画像を渡す場合、32×32ピクセルのパッチごとに1.5トークンとして課金される。1024×1024ピクセルの画像なら1,536トークンになる計算だ(Liquid AI公式ブログ)。欠陥検査のように画像を多用する用途では、この換算を踏まえて見積もる必要がある。
一方で、ベースにしたモデルの名前や、d1-ultra自体を重みごと公開するかどうかは、発表に記載がない。Jevのような完全クローズド運用になる可能性がある点は、自分のサーバーで動かしたい読者には留保として残る。
まとめ
Liquid AIが2026年10月15日に公開した判定AI「d1-ultra」は、性能の総合指標(Artificial Analysis Decision Index)で先行のJevを8ポイント上回った。それだけでなく、判定に添える「自信」の数字が実際の正答率とどれだけ一致するかを示す較正誤差でも、比較対象のうち最も正確だった。逆に、これまで本サイトが最大手の参入として扱ったOpenAIのGPT-6 Luna(Decisions API)が、最も自信過剰という結果になっている。
価格はJevと同じ入力100万トークンあたり0.042ドルで、利用は現時点Liquid AIのAPI経由に限られる。問い合わせの振り分けや欠陥検査のように、AIの自信の数字を基準に人の確認へ回すかどうかを決めている読者にとって、較正の良し悪しは性能の総合点と並ぶ選定基準になる。
コメント
気づきや感想をどうぞ記事への補足や、読んで考えたことをお寄せください。個人情報や、他の人を傷つける内容の投稿はお控えください。
投稿にはGoogleログインが必要です。
Googleでログイン投稿にはGoogleアカウントの表示名が公開されます。メールアドレスは取得・公開しません。
コメントを読み込んでいます…