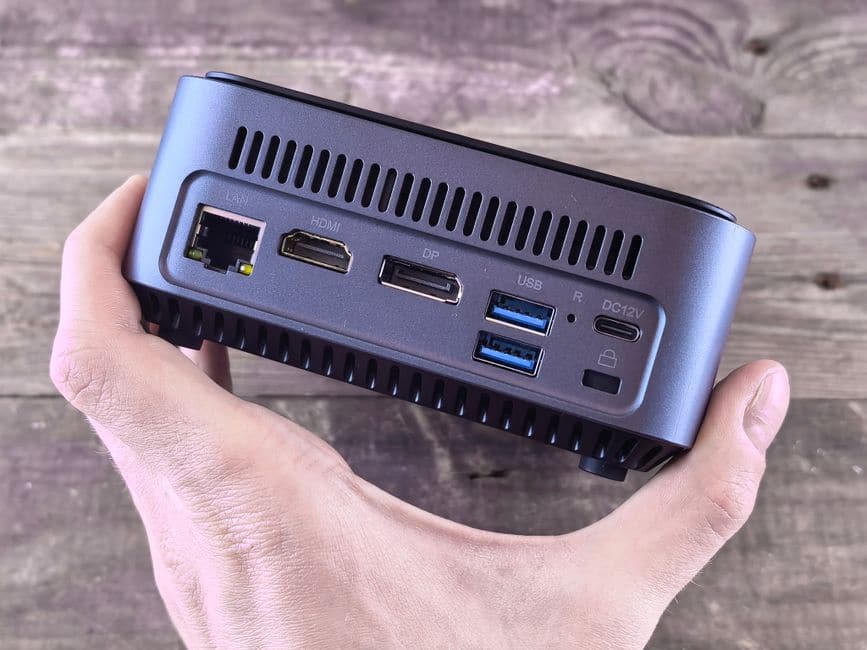
大学や企業の研究室でAIモデルを検証するとき、順番待ちの列に時間を取られることがある。共有のGPUクラスターは複数のチームで奪い合いになり、確保した計算時間を使い切るまで次の検証に進めない。
NVIDIAは2026年11月16日、米シカゴで開催中のスーパーコンピューティング会議「SC26」で「DGX Spark Developer Kit」を発表した。この製品は、机の上からこの順番待ちを消すためのものになる。手のひらに収まる小型コンピューター「DGX Spark」を4台つなぐだけで、合計512GBのメモリを持つクラスターができる。これで、パラメータ数700B(7000億)規模のモデルをローカルで動かせるようになる。
この記事が辿るのは、なぜ512GBのメモリで700Bパラメータのモデルに足りるのか、そして実際の研究室ではどれくらい変わったのか、という2つの疑問になる。
机の上に512GBのメモリ
DGX Spark単体は、150mm四方・厚さ50.5mm、重さ1.2kgの箱だ。中身は「GB10 Grace Blackwell Superchip」といい、CPUとGPUが128GBの統合メモリを共有する構成になっている。NVIDIA公式の製品ページによると、CPUはArmの20コア、GPUはBlackwell世代で、FP4・スパース利用時の理論性能は最大1PFLOPとある。
ふつうのPCでは、CPUが使うメモリとGPUが使うメモリは別々に積まれている。DGX Sparkはこの2つを1つのメモリとして扱う点が違う。
Developer Kitは、このDGX Sparkを4台まで増やせる仕組みだ。各台は隣り合う2台と直接つながり、リング状の輪になる。接続には、NVIDIA Blogによると「ConnectX-7」というNVIDIAのネットワーク技術を使う。ネットワークスイッチを別途買ったり設定したりする必要はない。1台から始めて、4台まで段階的に増設できる。
4台つないだときの合計は、512GBの統合メモリと20TBのNVMeストレージになる。128GB×4台という単純な掛け算が、NVIDIA Blogが明記する合計値512GBとちょうど一致する。クラスター全体が、1つの大きなメモリを持つ1台のマシンのように振る舞う計算だ。
ただ、512GBという容量は、700Bパラメータという規模のモデルに対して本当に足りるのだろうか。
700Bが机で動く理由
フル精度なら3倍近く足りない
AIモデルの多くは、パラメータ1つを16ビット(2バイト)の精度で保持する「FP16」という形式で配布されている。この精度のまま700Bパラメータのモデルを置こうとすると、700,000,000,000×2バイトで単純計算1,400GBになる。512GBの3倍近い容量が要り、4台のDGX Sparkをもってしても収まらない。
NVFP4という圧縮
ここで効いてくるのが「NVFP4」という形式だ。NVIDIA Developer Blogによると、NVFP4はBlackwell世代のGPUに対応した4ビットの浮動小数点形式だ。16個の値ごとに8ビットのスケール値を1つ共有する。このスケール分の上乗せを均すと、1パラメータあたり実効4.5ビットになる、と同ブログは説明している。
4ビットまで削ると精度が粗くなりそうだが、このブログの題は「効率的かつ正確な低精度推論」になっている。16個という小さな単位ごとに別々のスケール値を割り当てているのは、モデル全体で1つの値に落とすより誤差を抑えられるからだと自分は理解した。
この4.5ビットという数値を使って自分で計算すると、700Bパラメータに必要な容量が見えてくる。700,000,000,000×4.5ビット÷8で、約394GBになる。512GBの枠に対して約118GBの余裕が残り、この余白は計算の途中経過を保持するデータなどに回せる計算だ。
NVIDIA Blogは「NVFP4を使えば700Bパラメータのモデルを4台のクラスターでローカル実行できる」と結論だけを示している。この394GBという内訳は公式の数値ではなく、自分がNVFP4の仕様から導いた見立てになる。
FP16なら3倍近くはみ出し、FP8(1バイト/パラメータ)でも700GBと基準線を超える700Bパラメータのモデルがある。これがNVFP4に量子化するだけで、4台分のメモリに収まるようになる。
では、机の上にこれだけの容量ができたことで、実際の研究室では何が変わったのだろうか。
順番待ちが消えた現場
NVIDIA Blogは、Developer Kitを使った研究室の実例を紹介している。なかでもカリフォルニア大学バークレー校のRubin Lab(IGI)の数字に、自分はいちばん足を止めた。同研究室はNVIDIAのEvo 2モデルを使い、ゲノム配列から細菌の形質を予測する検証をしている。
NVIDIA Blogによると、この検証は従来「11時間のクラスター順番待ち」を経てから結果を受け取る流れだった。DGX Sparkに移してからは、その順番待ちがなくなり、結果を受け取るまでの時間が15倍速くなったという。11時間という具体的な待ち時間が、机の上のマシン1台でゼロになった、という対比の大きさに驚いた。
同じくUC BerkeleyのHartwig Groupは、化学の機械学習向けに「Nemotron 3 Super 120B-A12B」というモデルをLoRAという手法でファインチューニングしている。NVFP4量子化によって120Bクラスのモデルを1台のDGX Sparkに収め、複数日かかっていたクラスターの順番待ちを回避できるようになった。その結果、8〜24時間の学習を連続して回せるようになった、とNVIDIA Blogは報告している。
どちらの例も、モデルを動かす速さそのものより、「順番待ちをしなくてよくなった」という変化が大きい。研究室に割り当てられた固定の計算時間を使い切る前に、自分の机で先に試行錯誤できるようになったということだ。
誰が使えるのか
Developer Kitの対象は、NVIDIA Blogの表記では研究者・学術関係者・開発者になる。想定する用途もAIモデルだけに絞っていない。同ブログは、材料シミュレーションの「LAMMPS」や分子動力学の「NAMD」を4台構成で動かした実例を挙げている。流体力学の「OpenFOAM」や気象モデルの「WRF」も、コミュニティが動作を確かめたと紹介している。
実際に試すとなると、確認しておきたい条件が4つある。
- 対象: 研究者・学術関係者・開発者向け。個人の趣味用途を想定した表記ではない
- 購入経路: Acer、ASUS、Dell Technologies、GIGABYTE、H3C、HP、Lenovo、MSI、xFusionの各OEMパートナー、またはNVIDIA Marketplace
- 価格: NVIDIA Blog・製品ページのいずれにも記載がない
- 開発環境: GPU対応のC/C++/FortranコンパイラやMPIツールをまとめた「NVIDIA HPC SDK」のインストール用プレイブックは近日公開予定
4台分のDGX Sparkとケーブルをまとめて購入する形になるため、個人が気軽に試す価格帯というより、研究予算を持つ研究室・企業向けの製品だと自分は見ている。HPC SDKが揃えば、1台から4台まで分散処理の挙動を確かめてから、より大きなデータセンターのシステムへ移行する、という開発の流れが机の上だけで完結する。
まとめ
DGX Sparkは1台128GBの統合メモリを持つ手のひらサイズのコンピューターで、4台をConnectX-7でリング接続すると合計512GBのメモリになる。NVFP4という4ビット圧縮を使うと、このメモリに700Bパラメータ規模のモデルが収まる計算になる。実際にUC Berkeleyの研究室では、共有クラスターの順番待ちがなくなり、検証が15倍速く進んだ例が出ている。購入はOEM経由・NVIDIA Marketplaceで可能だが、価格は公開されておらず、研究予算を持つチーム向けの製品として位置づけられている。
コメント
気づきや感想をどうぞ記事への補足や、読んで考えたことをお寄せください。個人情報や、他の人を傷つける内容の投稿はお控えください。
投稿にはGoogleログインが必要です。
Googleでログイン投稿にはGoogleアカウントの表示名が公開されます。メールアドレスは取得・公開しません。
コメントを読み込んでいます…